从 Kubernetes、GPU 到 MCP 和 Agent Runtime,重新思考 AI 时代的基础设施与开源生态。
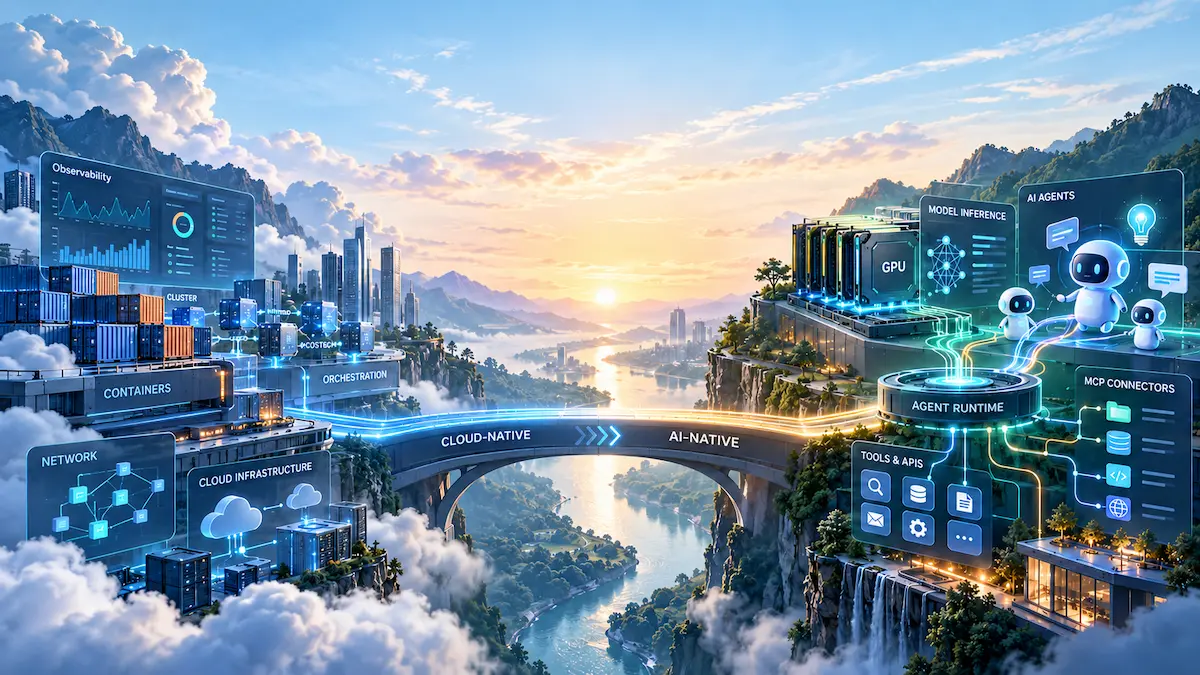
最近关注 Agentic AI Foundation(AAIF) 的发展时,我发现一个有趣的现象:过去十年在云原生社区认识的很多朋友,正在陆续进入 AI 领域。
有些前同事去了 OpenAI,有些人开始做 AI Gateway、MCP 和 Agent Framework,原本从事 Kubernetes、DevOps 和平台工程的开发者,也纷纷转向 GPU、模型推理与 Agent Runtime。
我自己同样经历了这一转变。从 Kubernetes、CNCF 和中国云原生社区,到在 Tetrate 工作五年,再到如今关注 HAMi、GPU 资源治理和 AI Native Infrastructure,我始终在思考如何让复杂系统更高效、可靠地运行。
但如今面对层出不穷的 AI Gateway、MCP Gateway、Agent Runtime、Sandbox 等新概念,我不禁产生一个疑问:
我们花了十多年建设起来的云原生基础设施,到了 AI 时代真的需要重新造一遍轮子吗?
AI 原生不是推倒云原生重来
回顾云原生的发展,Docker、Kubernetes 以及围绕 CNCF 形成的开源生态,解决了应用交付、资源编排、弹性伸缩、故障恢复、安全隔离和可观测性等一系列问题。
这些能力在 AI 时代并没有过时。
模型推理服务仍然需要调度和扩缩容,AI 平台仍然需要身份、安全和多租户管理,Agent 应用同样需要可靠性与可观测性。
真正不同的,是工作负载的特征。
传统 Web 服务主要关注请求吞吐量和延迟,大模型推理还需要考虑显存、KV Cache、首 Token 延迟(TTFT)和 Token 间延迟(ITL);传统应用的执行逻辑相对确定,而 Agent 可以动态规划任务、调用工具甚至生成代码。
AI 原生需要新的基础设施抽象,但不意味着过去十年的工程经验应该被抛弃。
在我看来,AI 原生不是云原生的替代品,而是一次围绕 AI 工作负载的基础设施重构。
Kubernetes 与 GPU:扩展旧架构,还是另起炉灶?
Kubernetes 是否适合 AI 工作负载,一直存在争议。
支持者认为,它已经提供成熟的声明式 API、控制器和资源编排能力;反对者则指出,它最初并非为 GPU、分布式训练和大规模推理设计。
我认为,争论的关键不在于要不要 Kubernetes,而在于哪些能力可以复用、哪些抽象需要改变。
以我目前参与的 HAMi 项目为例。传统 Kubernetes 对 GPU 的管理通常以整卡分配为主,容易造成小型推理和开发任务的资源浪费。
HAMi 通过扩展 Kubernetes 的设备管理与调度能力,支持 GPU 共享、资源分配和隔离,而不是重新实现一套容器编排系统。
但 GPU 共享不仅涉及资源利用率,还必须区分资源隔离、故障隔离和安全隔离。显存配额能够生效,并不代表一个任务发生故障时不会影响其他任务。
这正是 AI 工作负载给传统资源管理体系提出的新挑战。
而且,单纯提高 GPU 利用率并不等于降低业务成本。如果资源超配导致推理延迟上升、Agent 任务失败或反复重试,最终成本可能反而更高。
AI 基础设施的优化目标,应从 GPU 利用率进一步走向每次成功任务的成本、可靠性与服务质量。
从 Tetrate 到 AI Gateway:熟悉的技术正在进入新战场
2026 年 9 月,Tetrate 推动的 Agent Router 加入 AAIF。此前,Solo.io 的 agentgateway 也已加入基金会。
看到这些消息,我很有感触。过去熟悉的云原生基础设施公司,如今又在 AI 原生领域相遇。
这并不令人意外。
模型路由、负载均衡、身份认证、限流、安全策略和可观测性,本来就是 API Gateway 和云原生基础设施擅长解决的问题。
但 Agent 带来了新的挑战。
一次模型调用可以按 Token 计费;一次 MCP 工具调用可能涉及用户授权;一个 Agent 可能在执行过程中动态选择不同工具,甚至进行具有副作用的操作。
因此,AI Gateway 既应该复用 Envoy 等成熟的流量处理能力,也必须理解模型、工具和 Agent 的新语义。
问题在于:企业究竟需要一个统一的 AI Gateway,还是应该分别建设模型网关、MCP Gateway 和 Agent 协作网关?
这不是简单的产品命名问题,而是基础设施的职责边界问题。
MCP 与 Agent Runtime:哪些轮子确实需要重新设计?
MCP 的发展也让我想起过去云原生基础设施走过的路。
MCP 通过统一协议降低了 AI 应用连接工具和数据源的成本,但当 MCP Server 进入生产环境,扩展性、授权、负载均衡、故障恢复和审计等问题就会出现。
2026 年 MCP 向无状态协议核心演进,正说明了这一点:协议可以减少对连接会话的依赖,但业务状态、授权上下文和任务生命周期仍然需要明确管理。
这些都是分布式系统熟悉的问题。
不过,Agent Runtime 确实需要一些全新的抽象。
传统 Kubernetes Pod 可以承载 Agent 进程,但一个 Agent 任务可能跨越多个模型调用、执行环境和工具,甚至需要持续运行、暂停与恢复。
Pod 的生命周期不等于 Agent 任务的生命周期。
同样,容器和 Sandbox 可以提供执行隔离,却不能单独解决 Agent 的权限委托、工具授权和敏感操作审批。
因此,我更倾向于认为:
Agent Runtime 不需要重新发明容器,但需要在现有基础设施之上建立新的任务、状态与安全模型。
同时,AI 原生的安全设计不能只关注 Prompt Injection,还需要明确资源隔离、故障隔离与安全隔离,确保 Agent 即使犯错,其影响仍处于可控边界内。
AAIF 会成为 AI 原生时代的 CNCF 吗?
技术之外,更值得关注的是开源生态。
过去十年,CNCF 的价值不只是托管 Kubernetes,而是推动不同厂商围绕开放标准协作,逐渐形成完整的云原生生态。
今天,AAIF 正试图为 Agentic AI 建立类似的协作基础。MCP、A2A(Agent2Agent)以及 AI Gateway、开发工具等相关项目,正在探索协议互操作和中立治理。
但我认为,AAIF 是否能成为下一个 CNCF,现在还不能下结论。
它必须回答一个更深层的问题:既然已经有 CNCF、LF AI & Data 等组织,Agentic AI 为什么需要新的基金会?怎样避免不同基金会、协议和项目之间的重复建设?
会员和项目数量并不是成功的充分证据。真正重要的是跨厂商互操作、生产环境采用、开放治理,以及开发者能否持续参与技术决策。
随着 AI 让代码生成越来越容易,一个变化值得注意:
开源社区最稀缺的价值,可能正在从代码本身转向共识、信任和长期协作。
这也是我特别关注 AAIF 的原因。
从云原生到 AI 原生,也是一代开发者的转型
过去十年,我通过 CNCF、中国云原生社区和 Tetrate 认识了许多开发者。
如今,一部分人进入 OpenAI 等 AI 公司,一部分人开始做 Agent、MCP 和 AI Gateway,还有很多原来的 Kubernetes、平台工程和基础设施开发者,正在研究推理服务、GPU 和 AI 平台。
这并不只是大家追逐新的技术热点。
更重要的是,AI 正在产生大量与过去云原生相似、却又具有新特征的工程问题。
熟悉分布式系统的人需要学习模型和 Agent 的运行特征,而 AI 开发者同样需要学习可靠性、安全隔离、资源管理和生产运维。
未来真正有竞争力的工程师,可能不是只懂云原生或者只懂 AI 的人,而是能够理解二者边界、将它们结合起来的人。
我也希望这种跨领域的交流能够发生在开源社区中。
为什么我希望建设 AAIF 北京社区?
今年 9 月初,我已获批担任 AAIF Beijing Chapter Lead,开始参与推动 AAIF 北京站的建设。
过去十年,我持续参与 CNCF 和中国云原生社区的建设。一个重要体会是:真正有价值的技术社区,不只是举办大会或传播新闻,而是让不同背景的开发者建立持续的协作关系。
北京拥有丰富的 AI、云计算、平台工程和开源开发者资源。
我希望 AAIF 北京社区不仅面向 Agent 和 MCP 开发者,也能够连接 Kubernetes、GPU 基础设施、模型推理、AI Gateway、安全和平台工程领域的朋友。
通过技术分享、Meetup 和开源协作,让开发者交流真实的生产问题,参与国际项目的技术讨论,并将中国开发者的工程经验带入全球开源生态。
我也期待与过去十年在云原生社区结识的老朋友,以及正在进入 AI 领域的新朋友重新相聚。
总结
回到最初的问题:我们真的需要重新造一遍轮子吗?
我们不需要重新发明已经被验证的基础设施,但必须重新定义那些无法满足 AI 工作负载的新抽象。
Kubernetes 不需要被抛弃,但 GPU 和推理调度需要演进;Envoy 等网关技术值得复用,但 MCP 和 Agent 需要新的治理机制;容器与 Sandbox 仍然重要,但 Agent Runtime 需要独立的任务生命周期和权限模型;传统可观测性仍是基础,但 AI 平台需要关注任务成功率、端到端成本与服务质量。
AI 原生既不是云原生的简单升级,也不应该是一次全盘推倒重来。
十年前,我们围绕 Kubernetes 和 CNCF 建设云原生生态;十年后,又开始围绕 AI 原生讨论新的技术架构。
但我相信,真正推动技术前进的,仍然是开放标准、工程实践与开发者之间持续的协作。
你认为 AI 原生是云原生的自然演进,还是需要重新构建基础设施的新范式?
如果你正在开发 Agent、MCP、AI Gateway、模型推理或 GPU 平台,欢迎分享实际遇到的问题,尤其是那些现有云原生技术还无法很好解决的问题。
也欢迎加入 AAIF 北京社区,与更多新老朋友共同探索 AI 原生基础设施的未来。
加入 AAIF 北京社区
扫码下方的二维码,或者添加笔者微信
jimmysong,备注 AAIF,加入 AAIF 北京社区微信群,与关注 Agent、MCP、AI Gateway 和 GPU 基础设施的开发者一起交流。
参考文献
- HAMi 开源项目 - GitHub
- Agentic AI Foundation - aaif.io
- Model Context Protocol - modelcontextprotocol.io
- Agent Router - GitHub
- agentgateway - GitHub
本文仅代表个人观点。