博客写到第十年,列表页已经装不下这些内容之间的联系了:知识是网状的,页面却是一列一列的。所以我给全站画了一张图。
为什么做这件事
这个站现在有约 2000 个 Markdown 文件,博客、译文、图书、播客、公告混在一起。找个东西有搜索,逛东西靠标签和分类,但这些都回答不了一个问题:我正在读的这篇,在整站的知识版图里到底站在哪?
标签页给出的是“有哪些同类”,相关文章给出的是“编辑觉得相关”,都是一小片一小片的局部视图。我想要的是一个全局视角:打开任何一篇文章,能顺手看到它和全站其他内容的联系,标签只是其中一种线,章节归属、正文里的相互引用,都应该是图上的边。
于是有了这次上线的知识图谱面板:屏幕右缘一个不起眼的小标签,点开就是一个全站关系网。
它长什么样
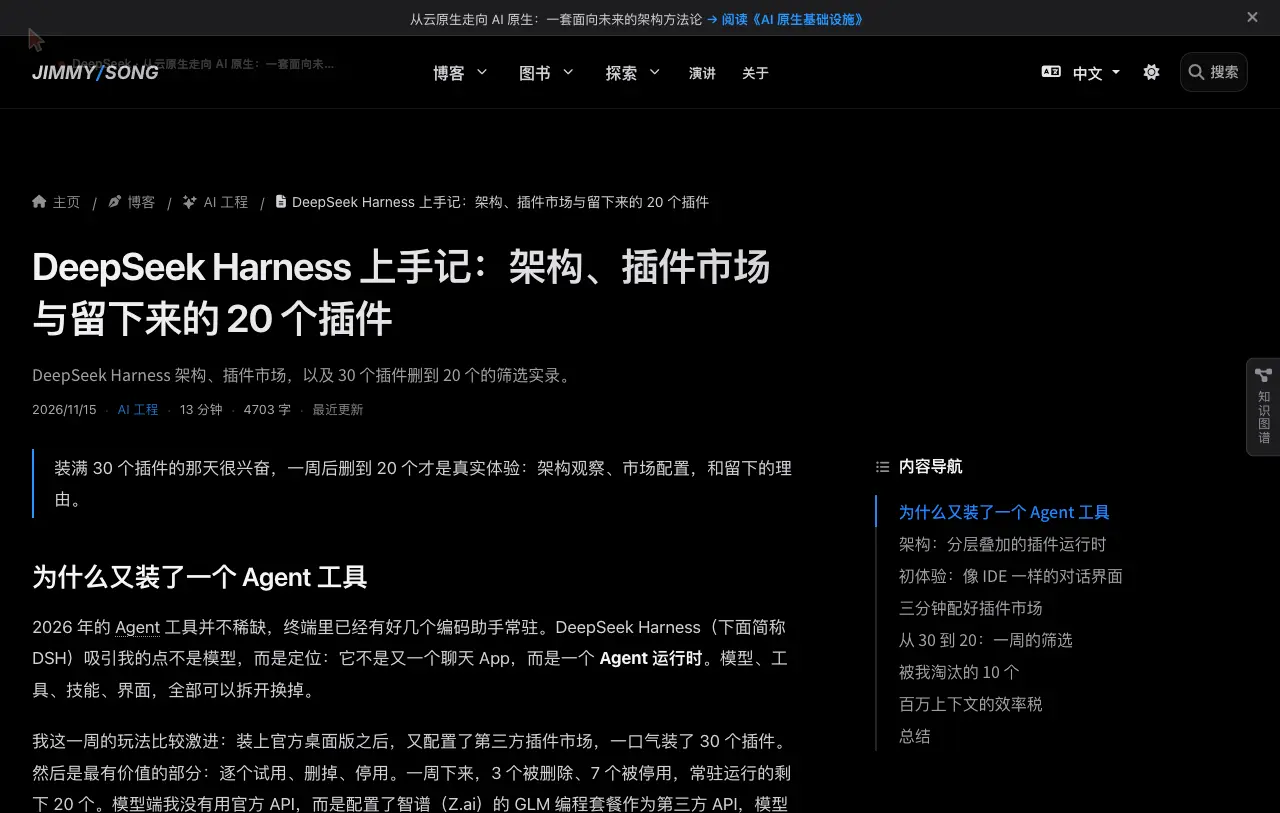
入口挂在屏幕右缘,竖排的“知识图谱”四个字。只在两类页面出现:博客和译文文章页,以及图书页。为什么不做成独立的全屏页面?因为这张图的价值在“我正在读的这一页在图里的位置”,脱离当前页面的全屏版反而没有锚点。
点击标签,右侧滑出一个抽屉,全站图谱直接摊开:
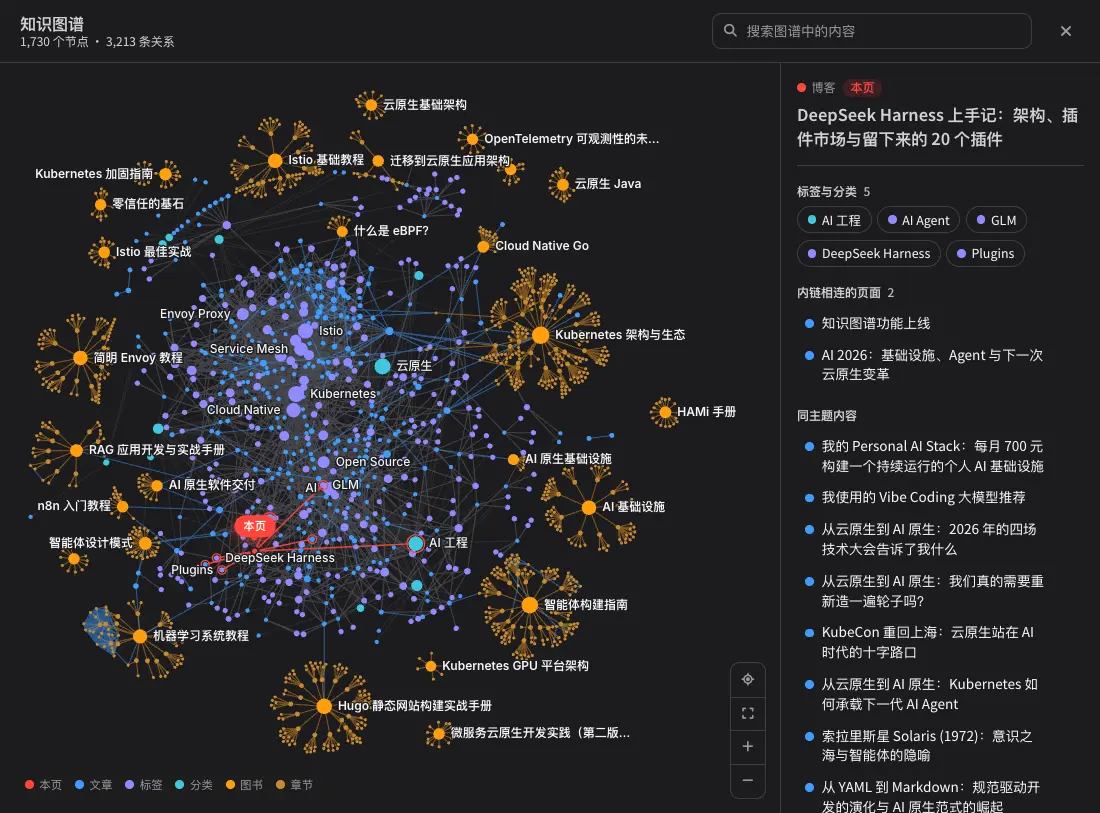
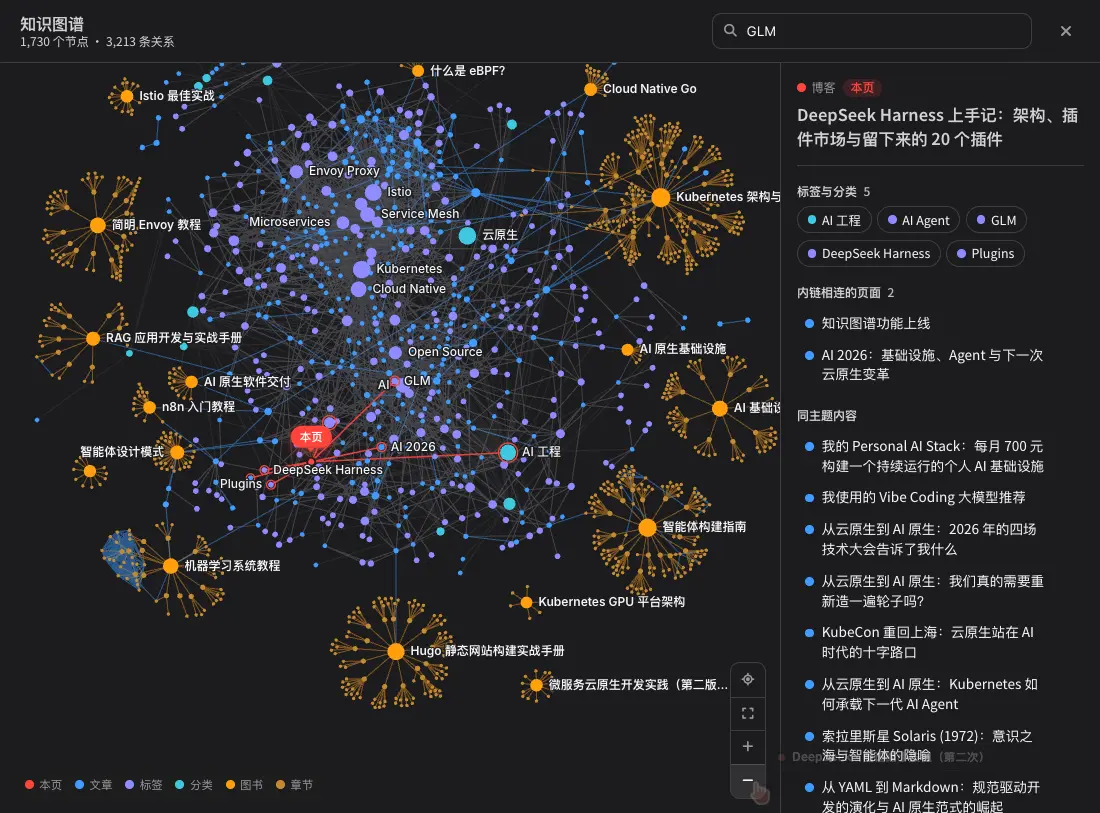
中央蓝紫色的一团是文章和标签,外围一个个橙色星团是图书和它们的章节。左下角是六色图例:本页、文章、标签、分类、图书、章节。打开面板时,当前页会自动标记成红色“本页”徽章,它的直接关系用红线连出来,右侧详情面板同步列出这个页面的全部关系,按“标签与分类”“内链相连的页面”“同主题内容”分组,点谁看谁。
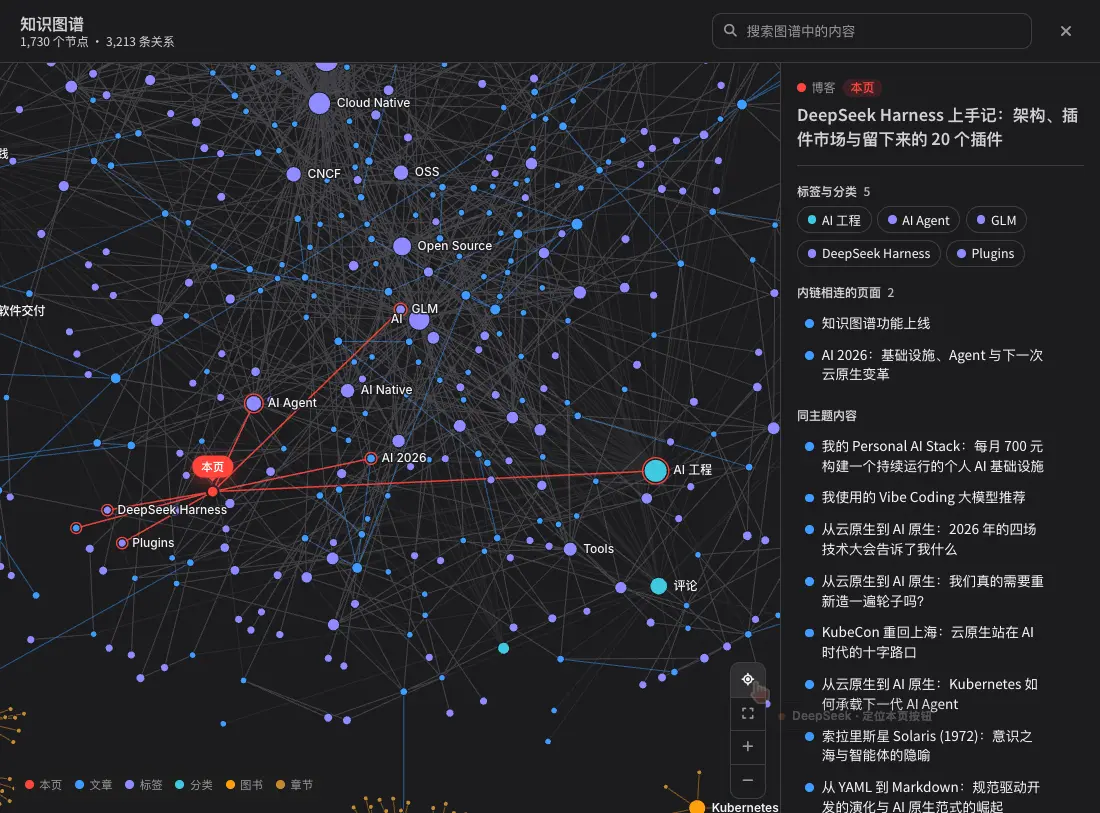
顶部的搜索框可以直接搜节点。比如搜 GLM,一秒定位到这个标签在图里的位置:
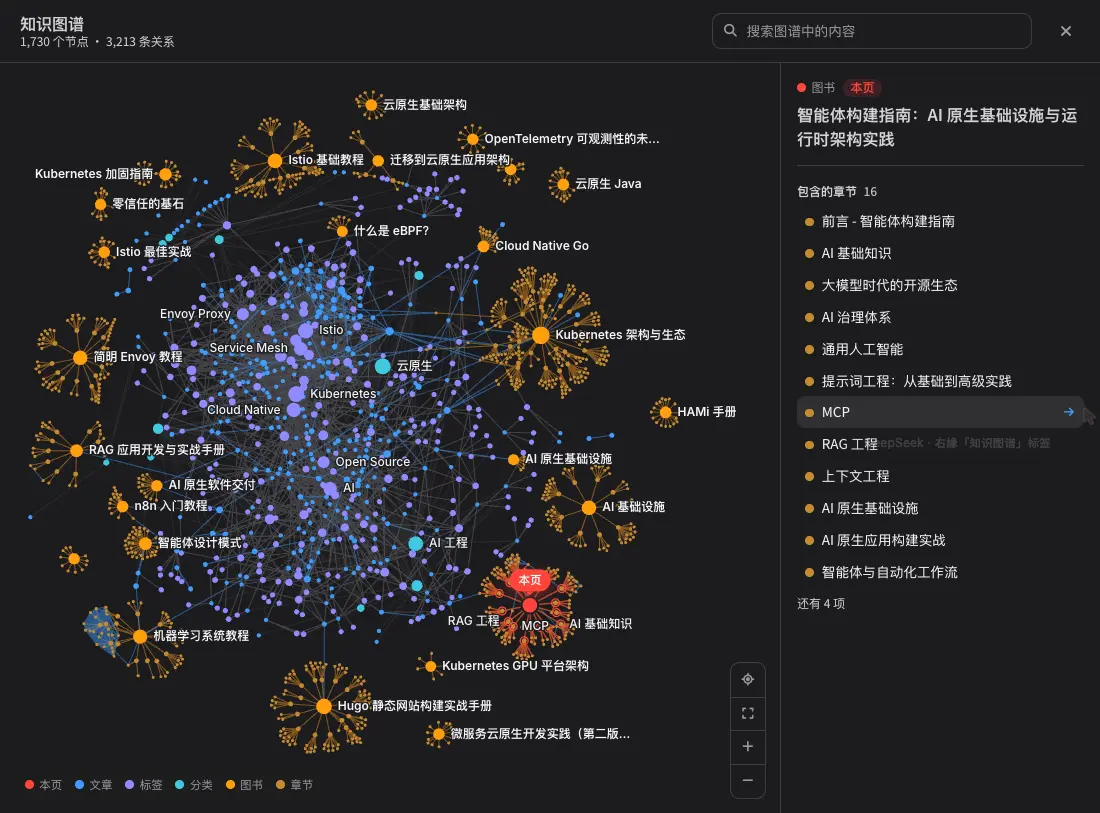
图书页同样适用。打开《智能体构建指南》的任意一章,面板里能看到整本书 16 个章节摊开成星团,本页高亮:
同期上线的还有文章底部的反向链接:每篇文章结尾会列出全站有哪些页面在正文里链接了它,标题就叫“引用本文的内容”。图谱负责向前探索,反向链接负责回答“谁在引用我”,两个方向都通了。
数据:构建期就把图画好
先说架构决策:图的构建完全放在构建期,浏览器只负责渲染。这意味着运行时零计算、零依赖,静态站点该怎么部署还怎么部署。
数据管线是一个 Hugo 局部模板(layouts/partials/knowledge-graph/data.html),构建时遍历全站页面,输出 nodes 和 edges 两个数组。节点有八种类型:
| 类型 | 说明 |
|---|---|
| blog / trans / notice / podcast | 独立内容页,各为一个节点 |
| book | 每本图书一个节点 |
| chapter | 图书内的每个章节页,挂在所属图书下 |
| tag / category | 标签和分类的 term 页 |
边有四类,用一个字母编码:
| 编码 | 关系 | 方向 |
|---|---|---|
| t | 页面 → 标签 | 多对一 |
| c | 页面 → 分类 | 多对一 |
| b | 章节 → 父章节或图书 | 树状 |
| l | 页面 ↔ 页面正文内链 | 双向 |
其中 l 边最有意思:它从渲染后的正文里提取内部链接,是文章之间真实引用关系的记录,不依赖任何人工维护。
数据通过一个无头页面输出成 JSON 端点。所谓无头,就是一个只有 front matter、没有正文的页面,指定 outputs: ["JSON"],且在 sitemap 里禁用:
---
title: "知识图谱数据"
type: pages
layout: knowledge-graph
outputs: ["JSON"]
sitemap:
  disable: true
---
中英文两个语言站各生成一份。中文站 1802 个节点、3213 条边,JSON 体积 302KB,gzip 后 70KB;英文站 503 个节点、1157 条边。对一个静态站来说,这个体积完全可以接受。
渲染:d3-force 加 Canvas,全部懒加载
前端代码在 assets/js/knowledge-graph/ 下,四个模块各管一段:model.js 负责把 JSON 变成带邻居关系的图对象,layout.js 负责力的计算,view.js 是 Canvas 渲染器和相机,index.js 把面板的开关、搜索、详情列表这些“壳”粘在一起。
挂载由 layouts/partials/knowledge-graph/panel.html 控制:文章页和图书页才渲染入口,JS 通过 Hugo 的 js.Build 打包成 IIFE,生产环境加指纹。整个 bundle 38.6KB,gzip 后 14.8KB。
关键的取舍是加载时机。图数据和渲染代码都是点击标签那一刻才拉取的,悬停在标签上时会预取,但真正解析和布局还是等到点击。没有人在页面加载时为一张自己还没打算看的图付出带宽。
布局用的是 d3-force:斥力把节点推开,链接力按距离约束相连节点,碰撞力防止重叠,再加轻微的向心力收拢整体。为了两次访问之间不重复烧 CPU,布局结果会带版本号缓存进 localStorage,参数变了版本号一升,旧缓存自动作废。实测冷启动约 2 秒(含下载和力导向迭代),缓存命中后 0.1 秒出头就能出图。
有两个渲染细节值得一提。一是初始位置不用随机数,用黄金角螺旋播种,同一个图每次初始排布都一致,布局缓存的命中率也因此稳定。二是 Canvas 只画最多 90 个标签,缩放超过 8 倍封顶,1800 个节点全开标签既是性能灾难也没法读,标签密度随缩放渐进显示就好。
交互:围绕“本页”设计
面板的所有交互都围绕一个核心问题:我在哪,我旁边有什么。
打开即定位。面板加载完会自动选中当前页,红色徽章标出“本页”,相机直接推进到它附近,右侧详情列出它的全部关系。不用先看完全图再自己找,那个“我在哪”的瞬间在打开的一秒内就完成了。
选中任何一个节点,它的直接邻居、在图书树上的祖先、以及(对图书和章节来说)整棵子树会被聚光显示,其余节点降为背景。这个“聚光”集合的计算只有十几行:
export function spotlightOf(node) {
  const set = new Set([node, ...node.neighbors, ...trailOf(node)]);
  const visited = new Set([node]);
  const queue = node.children.slice();
  while (queue.length) {
    const child = queue.pop();
    if (visited.has(child)) continue;
    visited.add(child);
    set.add(child);
    queue.push(...child.children);
  }
  return set;
}
细节上,暗色模式跟随站点主题,390px 窄屏可用,支持键盘操作,Esc 关闭,并且尊重系统的“减少动态”偏好设置。这些不是锦上添花:一张会动的图如果不照顾这些,可访问性就先输了。
总结
这次上线的核心其实是一次视角切换:把博客从“一列文章”变成“一张知识网络”。构建期画图、运行时只渲染的架构让它在静态站上几乎零成本;围绕“本页”设计的定位和聚光让全局视角不脱离当前语境;懒加载和布局缓存把性能开销压到点击之后。
你现在打开全站任意一篇文章或图书页面,右缘点一下就能看到它在知识版图里的位置。以最新这篇《DeepSeek Harness 上手记》为例,打开面板,你会看到它挂在 AI Agent、DeepSeek Harness、Plugins、GLM 这几个标签上,和《知识图谱功能上线》公告、AI 2026 年度观察这些页面连在一起。知识之间的路,从此不用再靠搜索碰运气。